Notes 3
Entwurf aus dem letzten Wintersemester. Nach der Vorlesung aktualisieren wir diese Seite, in der Regel ein bis zwei Tage später. Was sich geändert hat, steht dann hier. Geänderte und neue Absätze haben links einen Strich.
Sie können diese Seite ausdrucken oder mit einem PDF-Drucker in ein PDF umwandeln, um Ihre eigenen Notizen hinzuzufügen.
Willkommen!
In Woche 0 haben wir die Idee eines Algorithmus eingeführt: eine Blackbox, die eine Eingabe entgegennehmen und eine Ausgabe erzeugen kann.
In dieser Woche werden wir unser Verständnis von Algorithmen durch PseudocodeDie Schritte eines Programms in normaler Sprache, ohne die Regeln einer Programmiersprache. Oft schreibt man ihn als Kommentare in die Datei, bevor man den eigentlichen Code schreibt. Glossar → und Code erweitern.
Außerdem werden wir uns mit der Effizienz von Algorithmen befassen. Und wir werden die Programmierkonstrukte, die wir in den letzten Wochen gesehen haben zur Erstellung von Algorithmen verwenden.
Erinnern Sie sich an den Anfang des Kurses, als wir uns das folgende Diagramm angesehen haben:
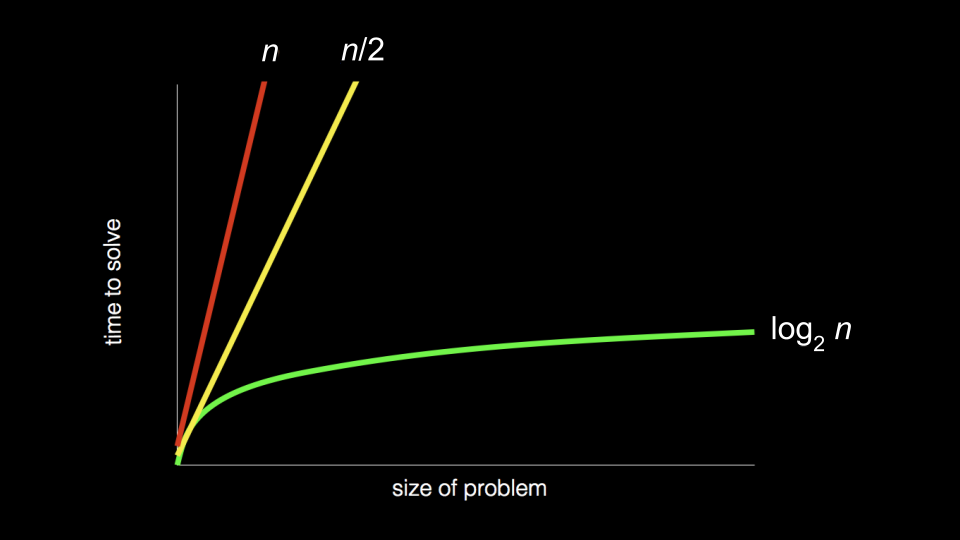
complexity In dieser Woche werden wir sehen, wie die Art und Weise, wie ein Algorithmus mit einem Problem arbeitet, die Zeit bestimmen kann, die er zur Lösung eines Problems benötigt. Algorithmen können – bis zu einer gewissen Grenze – immer effizienter gestaltet werden.
Hörsaalübung: Logarithmisches Zählen
Problem: Wie viele Menschen sind im Raum?
Algorithmus:
- Alle stehen auf
- Jeder denkt: 1
- Bildet Paare, sagt Zahlen, addiert im Kopf
- Eine Person setzt sich hin (andere merkt sich Summe)
- Noch stehend? → Zurück zu 3
- Letzte Person: Nennt Gesamtzahl
→ Alle aufstehen! Los geht’s!
Wiederholung: Problem 1 und 2
- Siehe Vorlesungsfolien.
Lineare Suche
Erinnern Sie sich an die Idee eines Arrays, d.h. Speicherblöcke, die aufeinander folgen: Seite an Seite mit anderen.
Sie können sich ein Array metaphorisch wie eine Reihe von Fächern vorstellen.
Nehmen wir an, in jedem Fach liegt ein Zettel mit einer Zahl und wir wollen wissen: “Ist die Zahl 50 in einem der Fächer?“ So wie wir muss ein Computer jedes Fach der Reihe nach anschauen, um herauszufinden, ob sich die Zahl 50 darin befindet. Zu ermitteln, ob ein bestimmtes Element im Array enthalten ist oder nicht, ist ein Standard-Problem der Informatik, die Suche.
Wir können unser Array an einen Such-Algorithmus übergeben, der es durchsucht, um zu sehen, ob sich die Zahl 50 in einem der Fächer befindet. Der Algorithmus gibt entweder true oder false zurück.
Um diese Aufgabe zu bewältigen könnte der Algorithmus in etwa so vorgehen:
Für jedes Fach von links nach rechts
    Wenn 50 im Fach ist
        Rückgabe true
Rückgabe false
Die obigen Anweisungen sind Pseudocode: Eine für Menschen lesbare Version der Anweisungen.
Eine Informatikerin oder ein Informatiker würde den Pseudocode vielleicht wie folgt aufschreiben:
For i from 0 to n-1
    If 50 in boxes[i]
        Return true
Return false
Beachten Sie, dass es sich bei der obigen Darstellung noch nicht um Code handelt, aber es ist schon eine ziemlich gute Annäherung an den endgültigen Code.
Wie heißt das Standardproblem der Informatik, zu ermitteln, ob ein bestimmtes Element in einem Array enthalten ist?
Antwort
Die Suche.
Was gibt der Suchalgorithmus im Beispiel mit den Fächern zurück?
Antwort
true oder false, je nachdem, ob die Zahl in einem der Fächer liegt.
Wie geht die lineare Suche vor?
Antwort
Sie schaut jedes Fach der Reihe nach an, von links nach rechts.
Was ist Pseudocode?
Antwort
Eine für Menschen lesbare Version der Anweisungen, noch kein Code, aber eine Annäherung daran.
Binäre Suche
Die Binäre Suche ist ein weiterer Suchalgorithmus, der bei unserer Aufgabe, die 50 zu finden, eingesetzt werden könnte.
Unter der Annahme, dass die Werte in den Fächern vom kleinsten zum größten Wert geordnet sind, würde der Pseudocode für die binäre Suche wie folgt aussehen:
Wenn keine Fächer mehr vorhanden sind
    Rückgabe false
Wenn 50 im mittleren Fach ist
    Rückgabe true
Sonst wenn 50 < Wert im mittleren Fach
    Linke Hälfte durchsuchen
Sonst wenn 50 > Wert im mittleren Fach
    Rechte Hälfte durchsuchen
Wenn wir die Array-Schreibweise nutzen, würde der Pseudocode so aussehen:
If no boxes left
    Return false
If 50 in boxes[middle]
    Return true
Else if 50 < boxes[middle]
    Search boxes[0] through boxes[middle - 1]
Else if 50 > boxes[middle]
    Search boxes[middle + 1] through boxes[n - 1]
Diese Annäherung an den Code zeigt schon ganz gut, wie man die Binäre Suche programmieren würde.
Was setzt die binäre Suche über die Werte im Array voraus?
Antwort
Sie müssen sortiert sein, vom kleinsten zum größten Wert.
Welches Fach schaut sich die binäre Suche als Erstes an?
Antwort
Das mittlere Fach.
Bei der binären Suche ist die gesuchte Zahl kleiner als der Wert im mittleren Fach. Wo sucht der Algorithmus weiter?
Antwort
In der linken Hälfte, also von boxes[0] bis boxes[middle - 1].
Wann gibt die binäre Suche false zurück?
Antwort
Wenn keine Fächer mehr übrig sind.
Laufzeit
Wenn wir Algorithmen hinsichtlich ihrer Effizienz im Hinblick auf ihre Laufzeit analysieren, erfolgt dies in der Regel mit der O-Notation. Werfen Sie einen Blick auf das folgende Diagramm:
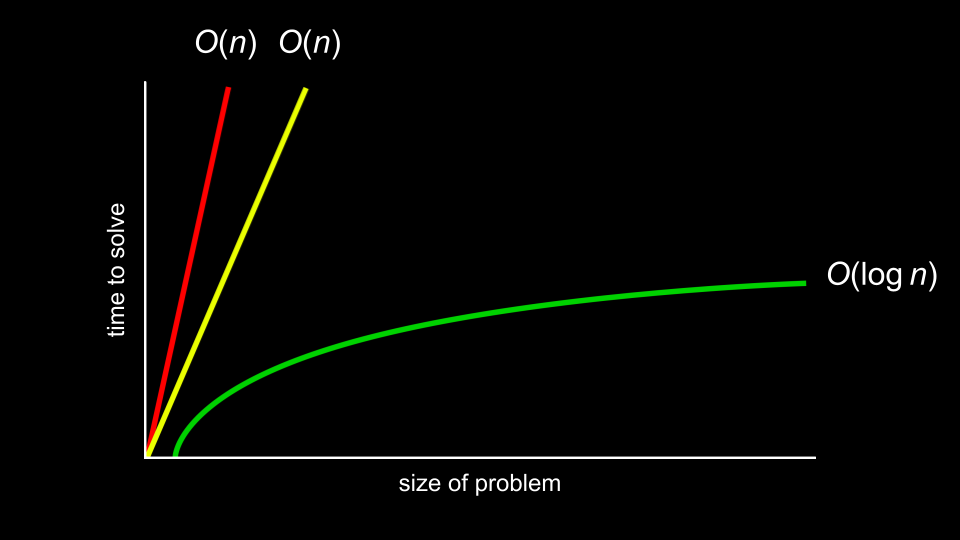
big o graphed Anstatt die Laufzeit eines Algorithmus ganz genau zu messen, interessieren wir uns in der Informatik eher für die Ordnung der verschiedenen Laufzeiten.
In der obigen Grafik hat der erste Algorithmus eine Laufzeit von der Ordnung von n. Der zweite läuft ebenfalls in linearer Zeit. Beim dritten ist die Laufzeit von logarithmischer Ordnung.
Es ist die Form der Kurve, die die Effizienz eines Algorithmus zeigt.
Bei den oben genannten Laufzeiten betrachten wir immer den Worst Case, also wenn wir kein Glück haben.
Die lineare Suche benötigt im schlechtesten Fall n Schritte.
Die binäre Suche ist im schlechtesten Fall besser als die lineare Suche, weil sie auch im ungünstigsten Fall immer weniger Schritte benötigt.
Wir interessieren uns sowohl für den schlechtesten Fall (Obergrenze) als auch für den besten Fall (Untergrenze).
Das Symbol Ω (Omega) wird verwendet, um den besten Fall eines Algorithmus zu kennzeichnen.
In anderen Kursen werden Sie sich detaillierter mit der Komplexität von Algorithmen befassen.
Mit welcher Notation beschreibt man in der Regel die Laufzeit von Algorithmen?
Antwort
Mit der O-Notation.
Was interessiert in der Informatik bei der Laufzeit eines Algorithmus, statt sie ganz genau zu messen?
Antwort
Die Ordnung der Laufzeit, also die Form der Kurve.
Welchen Fall betrachten die Laufzeiten in O-Notation in dieser Vorlesung?
Antwort
Den schlechtesten Fall (Worst Case), also die Obergrenze.
Kür: Wofür steht das Symbol Ω (Omega) bei Laufzeiten?
Antwort
Für den besten Fall eines Algorithmus, also die Untergrenze.
Wie viele Schritte braucht die lineare Suche im schlechtesten Fall bei n Elementen?
Antwort
n Schritte.
search.c
Sie können eine lineare Suche implementieren, indem Sie
code search.cin Ihr TerminalfensterFenster, in dem Sie dem Computer Befehle als Text eintippen statt zu klicken. In VS Code liegt es im unteren Bereich des Fensters. Glossar → eingeben und folgenden Code schreiben:#include <cs50.h> #include <stdio.h> int main(void) { int numbers[] = {20, 500, 10, 5, 100, 1, 50}; int n = get_int("Zahl: "); for (int i = 0; i < 7; i++) { if (numbers[i] == n) { printf("Found\n"); } else { printf("Not found\n"); } } }Dieser Code hat einen Bug, oder? Vielleicht sollten wir es nicht mit if-else programmieren.
#include <cs50.h>
#include <stdio.h>

int main(void)
{
    int numbers[] = {20, 500, 10, 5, 100, 1, 50};

    int n = get_int("Zahl: ");
    for (int i = 0; i < 7; i++)
    {
        if (numbers[i] == n)
        {
            printf("Found\n");
        }
    }
    printf("Not found\n");
}
Dieser Code hat auch noch einen Bug. Wie können wir das besser machen? Wir müssen die Schleife vorzeitig verlassen, wenn wir die Zahl gefunden haben.
#include <cs50.h>
#include <stdio.h>

int main(void)
{
    int numbers[] = {20, 500, 10, 5, 100, 1, 50};

    int n = get_int("Zahl: ");
    for (int i = 0; i < 7; i++)
    {
        if (numbers[i] == n)
        {
            printf("Found\n");
            return 0;
        }
    }
    printf("Not found\n");
    return 1;
}
Beachten Sie, dass die Zeile, die mit
int numbers[]beginnt, es uns ermöglicht, die Werte der einzelnen Elemente des Arrays zu initialisieren – die Länge ermittelt der CompilerProgramm, das Quellcode in Maschinencode übersetzt; diesen Vorgang nennt man kompilieren. Jedes C-Programm muss kompiliert werden, bevor es laufen kann. Glossar → automatisch. Weiterhin haben wir in derfor-Schleife eine Implementierung der linearen Suche. Mitreturn 0wird der Erfolgsfall angezeigt und das Programm beendet.return 1wird verwendet, um das Programm mit einem Fehler zu beenden. Der Grund, warum man 0 für den Erfolgsfall nimmt, ist, dass es in der Regel nur einen Erfolgsfall gibt, aber mehrere mögliche Fehlerzustände. Nimmt man die 0 für den Erfolgsfall kann man alle übrigen Zahlen für die verschiedenen Fehlerzustände verwenden.Wir haben nun selbst eine lineare Suche in C implementiert!
Was wäre, wenn wir nach einer Zeichenkette innerhalb eines Arrays suchen wollten? Ändern Sie Ihren Code wie folgt:
#include <cs50.h>
#include <stdio.h>

int main(void)
{
    string strings[] = {"Schiff", "Auto", "Hund", "Katze", "Hut"};

    string s = get_string("String: ");
    for (int i = 0; i < 5; i++)
    {
        if (strings[i] == s)
        {
            printf("Gefunden\n");
            return 0;
        }
    }
    printf("Nicht gefunden\n");
    return 1;
}
Beachten Sie, dass wir dieses Mal nicht
==verwenden können, wie im vorigen Programm. Stattdessen verwenden wirstrcmp, das aus der BibliothekSammlung fertiger Funktionen, die Sie in eigenen Programmen aufrufen, zum Beispielprintfaus der Standardbibliothek von C oderget_intaus der CS50-Bibliothek. Glossar →string.hstammt.strcmpgibt0zurück, wenn die Zeichenketten gleich sind.#include <cs50.h> #include <stdio.h> #include <string.h> int main(void) { string strings[] = {"Schiff", "Auto", "Hund", "Katze", "Hut"}; string s = get_string("String: "); for (int i = 0; i < 5; i++) { if (strcmp(strings[i], s) == 0) { printf("Gefunden\n"); return 0; } } printf("Nicht gefunden\n"); return 1; }Warum ist es clever, dass
strcmpden Wert 0 zurückgibt? Nun,strcmpprüft die Strings nicht nur auf Gleichheit, sondern vergleicht sie hinsichtlich ihrer ASCII-betischen Reihenfolge (nützlich, falls Sie Strings sortieren möchten).Wenn wir diesen Code ausführen, iterieren wir über das Array von Zeichenketten, um prüfen, ob eine bestimmte Zeichenkette darin enthalten ist. Wenn Sie einen Segmentation Fault sehen, hat Ihr Programm einen Teil des Speichers berührt, auf den es keinen Zugriff haben sollte. Vergewissern Sie sich dann, dass Sie
i < 5und nichti < 6verwendet haben: Das Array hat nur 5 Elemente,strings[5]gibt es nicht.Wir können diese Ideen von Zahlen und Zeichenketten in einem einzigen Programm kombinieren. Geben Sie
code phonebook.cin Ihr Terminalfenster ein und schreiben Sie folgenden Code:#include <cs50.h> #include <stdio.h> #include <string.h> int main(void) { string names[] = {"Dominik", "Bittle", "Office"}; string numbers[] = {"+49-951-863-2661", "+49-951-863-2661", "+49-951-863-2795"}; string name = get_string("Name: "); for (int i = 0; i < 3; i++) { if (strcmp(names[i], name) == 0) { printf("Found %s\n", numbers[i]); return 0; } } printf("Not found\n"); return 1; }Beachten Sie, dass wir für die Telefonnummern keinen Integer- sondern einen String-Datentyp verwenden, weil wir nicht nur Ziffern, sondern auch Sonderzeichen speichern wollen. Dominiks und Bittles Telefonnummern sind
numbers[0]bzw.numbers[1]. Das Office hat die Nummer-2795, alsonumbers[2]. Das Programm erlaubt es uns, ein einfaches Telefonbuch nach der Nummer einer bestimmten Person zu durchsuchen.Das Design des Programms ist schlecht (man nennt so etwas auch Code Smell). Name und Nummer stehen in getrennten Arrays. Würden wir z.B. nur die Namensliste sortieren, müssten wir daran denken, die Telefonnummern auch entsprechend zu sortieren – sonst passt die Zuordnung über den Index nicht mehr.
Wäre es nicht schön, wenn wir einen eigenen Datentyp erstellen könnten, mit dem wir eine Person mit einer Telefonnummer verknüpfen können?
Wer bestimmt bei int numbers[] = {20, 500, 10, 5, 100, 1, 50}; die Länge des Arrays?
Antwort
Der Compiler, automatisch aus der Zahl der angegebenen Werte.
Welchen Wert gibt main im Erfolgsfall zurück?
Antwort
0 (return 0). Bei einem Fehler zum Beispiel return 1.
Warum steht als Rückgabewert von main gerade die 0 für Erfolg?
Antwort
Weil es meist nur einen Erfolgsfall, aber mehrere mögliche Fehlerzustände gibt. Die übrigen Zahlen bleiben für die verschiedenen Fehler.
Mit welcher Funktion vergleichen Sie in C zwei Strings, da == dafür nicht funktioniert?
Antwort
Mit strcmp aus der Bibliothek string.h.
Was gibt strcmp zurück, wenn die beiden Strings gleich sind?
Antwort
0.
Warum gibt strcmp bei Gleichheit 0 zurück und nicht einfach true?
Antwort
Weil strcmp die Strings auch nach ihrer ASCII-betischen Reihenfolge vergleicht. Das ist nützlich zum Sortieren.
Was bedeutet ein Segmentation Fault?
Antwort
Das Programm hat einen Teil des Speichers berührt, auf den es keinen Zugriff haben sollte.
Warum ist es schlechtes Design (ein Code Smell), Namen und Telefonnummern in zwei getrennten Arrays zu speichern?
Antwort
Sortiert man nur eine der beiden Listen, passt die Zuordnung über den Index nicht mehr.
structs
In C gibt es eine Möglichkeit, eigene Datentypen zu erstellen.
Wir können damit einen eigenen Datentyp namens “Person” erstellen, der zwei Informationen aufnimmt: “Name” und eine “Nummer”.
Ändern Sie Ihren Code dazu wie folgt:
#include <cs50.h>
#include <stdio.h>
#include <string.h>

typedef struct
{
    string name;
    string number;
}
person;

int main(void)
{
    person people[3];

    people[0].name = "Dominik";
    people[0].number = "+49-951-863-2661";

    people[1].name = "Bittle";
    people[1].number = "+49-951-863-2661";

    people[2].name = "Office";
    people[2].number = "+49-951-863-2795";

    string name = get_string("Name: ");
    for (int i = 0; i < 3; i++)
    {
        if (strcmp(people[i].name, name) == 0)
        {
            printf("Gefunden %s\n", people[i].number);
            return 0;
        }
    }
    printf("Nicht gefunden\n");
    return 1;
}
Beachten Sie, dass der Code mit
typedef structbeginnt, wo ein neuer Datentyp namenspersondefiniert wird. Innerhalb einerpersonbefindet sich ein String namensnameund ein String namensnumber. In der Funktionmainbeginnen wir mit der Erstellung eines Arrays namenspeople, das vom Typpersonist und eine Größe von 3 hat. Dann aktualisieren wir die Namen und Telefonnummern der drei Personen in unserempeople-Array. Beachten Sie vor allem, dass die Punktschreibweise, z. B.people[0].name, es uns ermöglicht, auf diePersonan der 0-ten Stelle zuzugreifen und dieser Person einen Namen zuzuweisen.
Mit welchem Konstrukt definieren Sie in C einen eigenen Datentyp wie person?
Antwort
Mit typedef struct.
Welches Problem des Telefonbuchs löst der eigene Datentyp person?
Antwort
Er verknüpft Name und Telefonnummer einer Person in einem Datentyp, statt sie auf zwei Arrays zu verteilen.
Wie greifen Sie auf den Namen der Person an Stelle 0 im Array people zu?
Antwort
Mit people[0].name (Punktschreibweise).
Problem 3: Anwendung von structs
- siehe Vorlesungsfolien
Zusammenfassend
In diesem Teil haben Sie etwas über algorithmisches Denken und das Erstellen eigener Datentypen gelernt. Insbesondere haben wir folgendes behandelt:
- Lineare Suche und binäre Suche.
- O-Notation (und ).
- structs.
Sortieren (Selection Sort, Bubble Sort, Merge Sort) und Rekursion folgen im zweiten Teil der Vorlesung.
Die Fragen zum Selbsttest helfen beim aktiven Lesen. Sie sind kein Vorgeschmack auf die Prüfung: Fragen und Antworten auswendig zu lernen reicht nicht zum Bestehen und ist vermutlich auch keine sinnvolle Vorbereitung. Was hilft: Wie Sie Inf-Einf-B bewältigen.
Diese Seite als Markdown: ansehen herunterladen